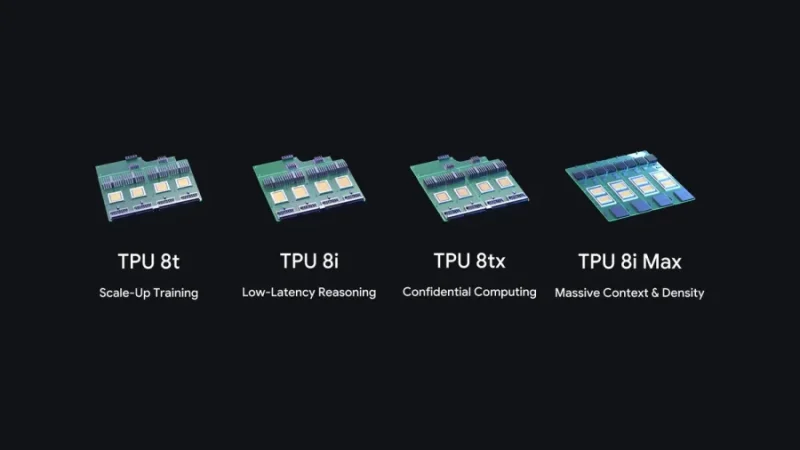
Google anunció este lunes 9 de noviembre dos nuevas configuraciones de sus aceleradores de inteligencia artificial: TPU 8tx y TPU 8i Max. La primera se dirige al procesamiento confidencial de datos y modelos; la segunda aumenta la capacidad para cargas que necesitan manejar grandes cantidades de información en una misma tarea. Con estos sistemas, la compañía completa cuatro variantes de la octava generación de TPU presentadas durante 2026.
Dos problemas distintos para la misma generación
Las unidades de procesamiento tensorial, conocidas como TPU, son componentes especializados que Google utiliza para entrenar y ejecutar modelos de inteligencia artificial. La empresa presentó en abril las variantes 8t, orientada al entrenamiento de grandes modelos, y 8i, dirigida a tareas de razonamiento con baja latencia. El anuncio de noviembre no describe dos generaciones de chips nuevas: añade sistemas construidos alrededor de esa misma base técnica con combinaciones diferentes de cómputo, memoria, redes y seguridad.
La distinción entre chip y sistema es importante para entender el alcance de la noticia. Un chip requiere diseñar y fabricar silicio durante un proceso largo. Un sistema puede modificar el empaquetado de los componentes, su conexión con memoria y procesadores anfitriones, y la forma en que se distribuye el trabajo. Google sostiene que esa arquitectura modular le permite responder con más rapidez a necesidades que cambian a medida que las empresas despliegan modelos y agentes de IA.
La compañía afirma que ya tiene cerca de 100 clientes de TPU, entre laboratorios de modelos, universidades, minoristas y firmas financieras. También señala que utiliza estos procesadores en Gemini y en servicios de su nube, y que algunos clientes pueden instalarlos en sus propios centros de datos. Son datos proporcionados por la empresa, no una auditoría independiente de adopción o rendimiento.
8tx protege datos mientras el modelo los procesa
TPU 8tx está planteado para organizaciones que trabajan con datos sensibles o modelos propietarios, incluidos gobiernos y sectores regulados. Normalmente, la información puede cifrarse cuando se almacena o viaja por una red, pero debe estar disponible para ser procesada en memoria. Google dice que el nuevo sistema incorpora mecanismos de protección a nivel de hardware para mantener aislados datos y parámetros del modelo incluso durante el uso activo.
La configuración combina la base de silicio de TPU 8t con procesadores anfitriones AMD EPYC de quinta generación. También adopta una red de baja latencia llamada Boardfly. Según las pruebas y comparaciones presentadas por Google, esa combinación puede reducir la latencia hasta dos veces frente a TPU 8t con una penalización de rendimiento cercana a cero. La cifra es una afirmación de la fabricante para este producto y depende de las cargas de trabajo consideradas.
Google plantea que el sistema permita ejecutar inferencia, ajustar modelos con información privada y entrenar agentes sin mover datos sensibles entre distintos grupos de máquinas. Es una propuesta dirigida a quienes necesitan mantener controles de confidencialidad a lo largo de varias etapas del trabajo con IA. La presentación no significa que todas las aplicaciones de una organización adquieran automáticamente esas protecciones; su uso depende de la configuración y del despliegue.
8i Max duplica recursos en el mismo paquete
TPU 8i Max atiende otra limitación: la memoria necesaria para procesar contextos muy extensos. Reúne dos chips TPU 8i en un mismo paquete. Google asegura que, respecto de una unidad 8i, duplica cómputo, memoria SRAM y ancho de banda de memoria HBM. El objetivo es evitar que tareas como examinar grandes bases de código u horas de video queden limitadas por la velocidad con que pueden recuperarse los datos.
Al encajar más silicio en el espacio de rack existente, la compañía sostiene que los centros de datos pueden concentrar más capacidad de cálculo por superficie. El anuncio incorpora también herramientas de software para desarrolladores, entre ellas soporte para PyTorch y componentes abiertos destinados a facilitar el uso de TPU. La apuesta combina hardware especializado con un entorno de programación más accesible, aunque las ventajas concretas tendrán que evaluarse en las cargas reales de cada cliente.
Las cuatro variantes forman ahora una oferta diferenciada: 8t para entrenamiento, 8i para razonamiento de baja latencia, 8tx para procesamiento confidencial y 8i Max para contextos largos. El anuncio refleja la demanda de sistemas capaces de sostener aplicaciones de IA más complejas, pero las cifras de desempeño y adopción publicadas este lunes proceden de Google. La noticia verificable es la ampliación de su catálogo y las características que la empresa atribuye a cada configuración.
Fuentes: Google.